 HMT

783 字
4 分钟
pytorch学习01:梯度下降实现简单线性回归
描述
梯度下降算法是深度学习的一个基础概念,基本思想是利用梯度来尝试寻找使损失函数得到最小值的参数,以达到接近真实未知函数的目的。
本次利用python实现简单函数的梯度下降算法。
目标函数形式为:
损失函数形式为:
梯度下降的目的:
寻找使函数值最小的 和 。
梯度下降的步骤:
-
初始化w和b,本文均设置为0
-
计算当前w和b的梯度 dw 和 db
由 分别对 w 和 b 求导可得梯度的计算公式
,以下简称dw
,以下简称db
-
通过梯度和学习率 ( lr ) 更新w和b
-
重复执行2步,直到循环一定次数或损失满足一定条件
-
得到最终的 w 和 b 就是梯度下降的结果,可通过损失函数计算当前 w 和 b 的损失来对结果进行评估
实现代码
import random
def compute_error_for_line_given_points(b, w, points): ''' 计算损失
:param b: 偏置 :param w: 权重 :param points: 点 :return: 返回均方差 '''
totalError = 0 for index, [x, y] in enumerate(points): totalError += (y - (w * x + b)) ** 2 return totalError / len(points)
def step_gradient(b_current, w_current, points, learningRate): ''' 梯度下降
:param b_current: 当前偏置 :param w_current: 当前权重 :param points: 点 :param learningRate: 当前学习率 :return: 新偏置 new_b, 新权重 new_w '''
b_gradient = 0 w_gradient = 0 N = len(points)
''' loss = (wx + b - y) ** 2 db = 2(wx + b - y) dw = 2(wx + b - y) * x '''
# 求累加梯度 for index, [x, y] in enumerate(points): b_gradient += - 2 * (y - (w_current * x + b_current)) w_gradient += - 2 * (y - (w_current * x + b_current)) * x
# 求平均梯度 b_gradient /= N w_gradient /= N
# 梯度下降 new_b = b_current - learningRate * b_gradient new_w = w_current - learningRate * w_gradient
return new_b, new_w
def gradient_descent_runner(points, b_start, w_start, learningRate, epochs): ''' 梯度下降
:param points: 点 :param b_start: 初始偏置 :param w_start: 初始权重 :param learningRate: 学习率 :param epochs: 趟数 :return: 最重的b和w ''' b = b_start w = w_start
for i in range(epochs): b, w = step_gradient(b, w, points, learningRate)
return b, w
def createPoints(b, w, sX=-1, eX=1, num=10, delta=1): ''' 根据参数生成一些点
:param b: 偏置 :param w: 权重 :param sX: x的起始点 :param eX: x的结束点 :param num: 点的个数 :param delta: 随机浮动的范围,从 -delta/2 ~ delta/2 :return: 生成的点 ''' points = [] x = sX for i in range(num): y = x * w + b + (random.random() - 0.5) * delta points.append([x, y]) x += (eX - sX) / num
return points
if __name__ == "__main__": # 设置目标函数的权重和偏置 b = 4 w = 2
# 生成随机点 points = createPoints(b, w, -10, 10, 1000, 1)
# 设置参数 b_start = 0 w_start = 0 learningRate = 0.01 epochs = 100
# 开始梯度下降 b_final, w_final = gradient_descent_runner(points, b_start, w_start, learningRate, epochs)
# 计算损失 loss_final = compute_error_for_line_given_points(b_final, w_final, points)
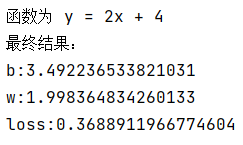
# 最终结果 print("函数为 y = {}x + {}".format(w, b)) print("最终结果:\nb:{} \nw:{}\nloss:{}".format(b_final, w_final, loss_final))最终结果
原文链接:CSDN
pytorch学习01:梯度下降实现简单线性回归
https://blog.homura.work/posts/csdn/118945703/