 HMT

1021 字
5 分钟
pytorch学习20:处理结构数据实例
简介
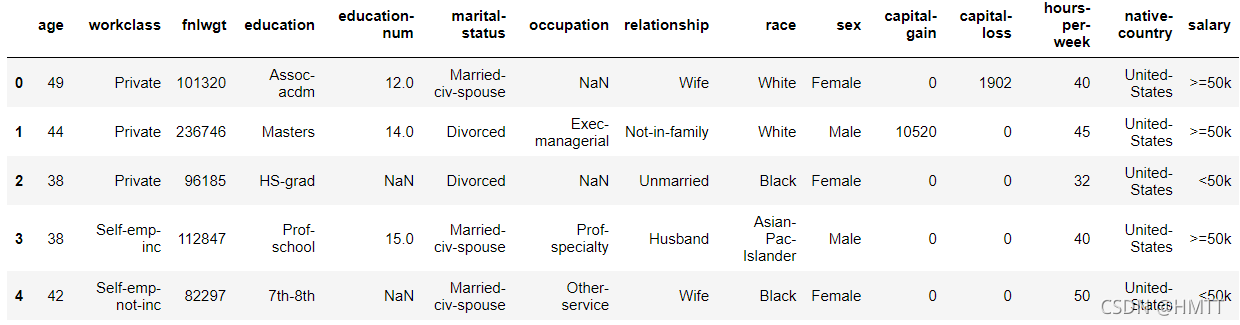
在对训练数据进行预处理时,我们有时会遇到结构化数据。结构化数据,是高度组织和整齐格式化的数据,是可以放入表格和电子表格中的数据类型,可以理解为一张表格。
本次使用adult.csv数据作为样例进行模型训练,数据连接如下:
https://github.com/zergtant/pytorch-handbook/blob/master/chapter5/data/adult.csv
数据结构如下图:
数据预处理
在处理数据之前,首先要读取数据。使用pandas对数据进行读取:
#读入文件df = pd.read_csv('./data/adult.csv')由于模型只能处理数值型数据,因此要先将结构化数据中的不同类型数据进行划分,如下:
#训练结果result_var = 'salary'#分类型数据cat_names = ['workclass', 'education', 'marital-status', 'occupation', 'relationship', 'race','sex','native-country']#数值型数据cont_names = ['age', 'fnlwgt', 'education-num','capital-gain','capital-loss','hours-per-week']然后需要将分类型数据转化为数值型数据,并进行缺失数据填充:
for col in df.columns: if col in cat_names: df[col].fillna('---') df[col] = LabelEncoder().fit_transform(df[col].astype(str)) if col in cont_names: df[col]=df[col].fillna(0)数据预处理完后就可以划分出训练数据和结果了
#分割下训练数据和标签Y = df['salary']Y_label = LabelEncoder()Y=Y_label.fit_transform(Y)X=df.drop(columns=result_var)定义数据集
当数据预处理完成后,就可以准备DataLoader了。
首先自定义一个Dataset类:
class tabularDataset(Dataset): def __init__(self, X, Y): self.x = X.values self.y = Y
def __len__(self): return len(self.y)
def __getitem__(self, idx): return (self.x[idx], self.y[idx])
train_ds = tabularDataset(X, Y)然后创建DataLoader对象:
#DataLoader加载数据train_dl = DataLoader(train_ds, batch_size=batch_size,shuffle=True)训练模型和测试结果
完整代码
在定义好数据集后,就可以进行模型训练了,训练过程与之前一样。完整代码如下:
import numpy as npimport pandas as pdimport torchimport torch.nn.functional as Ffrom sklearn.preprocessing import LabelEncoderfrom torch import nnfrom torch.utils.data import Dataset, DataLoaderfrom torch.utils.tensorboard import SummaryWriter
# 定义数据集class TabularDataset(Dataset): def __init__(self, X, Y): self.x = X.values self.y = Y
def __len__(self): return len(self.y)
def __getitem__(self, idx): return (self.x[idx], self.y[idx])
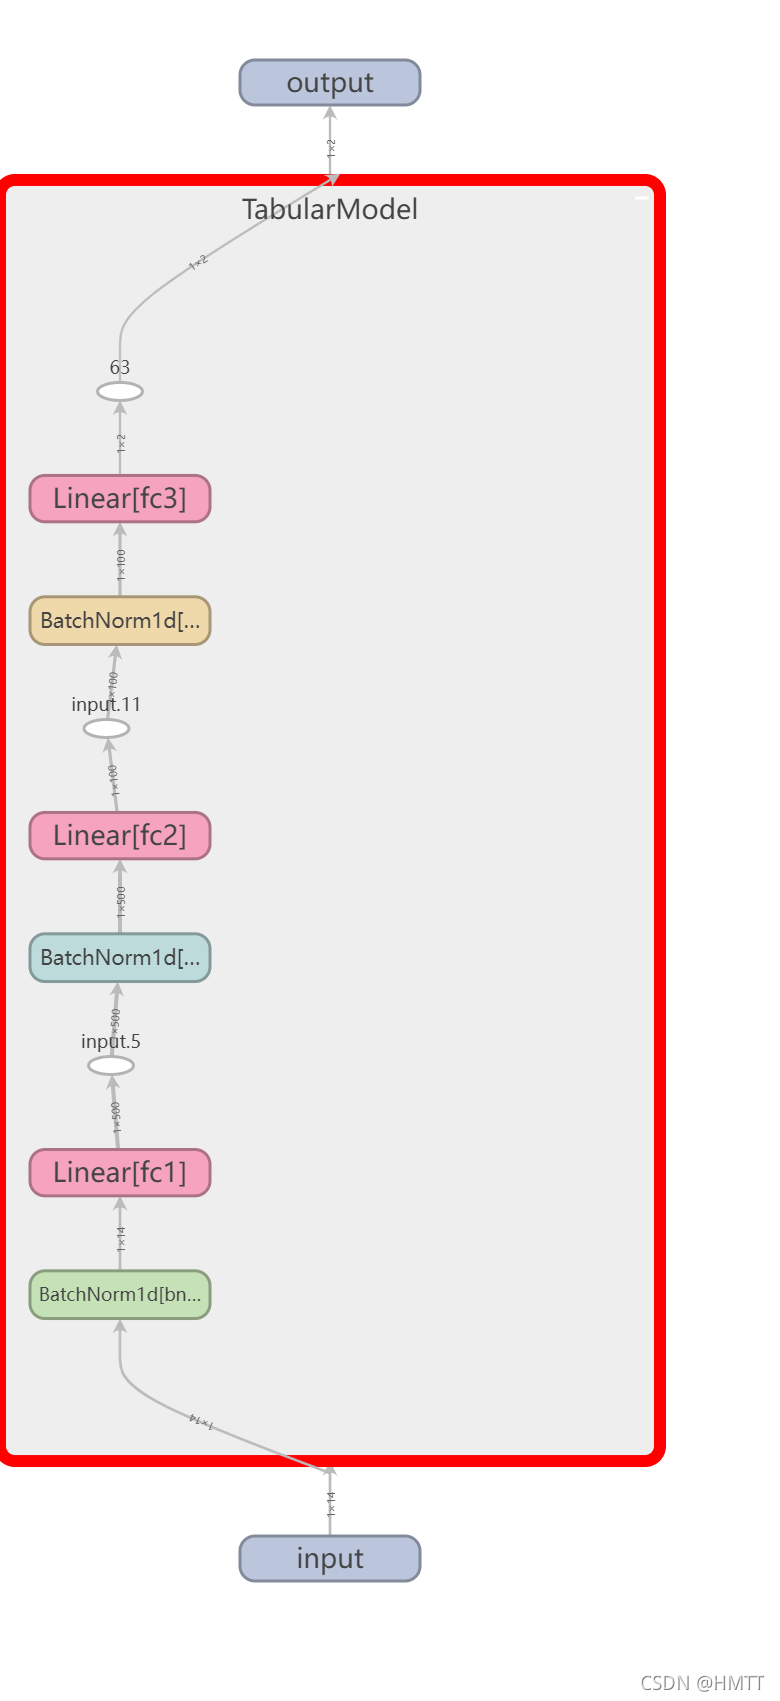
# 定义模型class TabularModel(nn.Module): def __init__(self): super().__init__() self.fc1 = nn.Linear(14, 500) self.fc2 = nn.Linear(500, 100) self.fc3 = nn.Linear(100, 2) self.bn_in = nn.BatchNorm1d(14) self.bn1 = nn.BatchNorm1d(500) self.bn2 = nn.BatchNorm1d(100)
def forward(self, x): x = self.bn_in(x) x = F.relu(self.fc1(x)) x = self.bn1(x)
x = F.relu(self.fc2(x)) x = self.bn2(x)
x = self.fc3(x) x = torch.sigmoid(x)
return x
def getData(batch_size): ''' 获得数据集 :param batch_size: 批大小 :return: 获得相应的DataLoader '''
df = pd.read_csv("./data/adult.csv") # 训练结果 result_var = "salary" # 分类型数据 cat_names = ['workclass', 'education', 'marital-status', 'occupation', 'relationship', 'race', 'sex', 'native-country'] # 数值型数据 cont_names = ['age', 'fnlwgt', 'education-num', 'capital-gain', 'capital-loss', 'hours-per-week']
# 将分类型数据转化为数字数据,并进行缺失数据填充 for col in df.columns: if col in cat_names: df[col].fillna("---") df[col] = LabelEncoder().fit_transform(df[col].astype(str)) if col in cont_names: df[col] = df[col].fillna(0)
# 分割训练数据和标签 Y = df["salary"] Y_label = LabelEncoder() Y = Y_label.fit_transform(Y) X = df.drop(columns=result_var) train_ds = TabularDataset(X, Y) # 使用DataLoader加载数据 train_dl = DataLoader(train_ds, batch_size=batch_size, shuffle=True) return train_dl
def train(model, train_dl, DEVICE, epochs=20, learning_rate=0.01): ''' 训练
:param model: :param train_dl: :param DEVICE: :param epochs: :param learning_rate: :return: '''
model.train() writer = SummaryWriter(log_dir="runs/train_data")
# 损失函数 criterion = nn.CrossEntropyLoss() # 优化器 optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
# 记录损失 losses = [] for epoch in range(epochs): for i, (x, y) in enumerate(train_dl): x = x.float().to(DEVICE) y = y.long().to(DEVICE) # 清除梯度累积 optimizer.zero_grad() # 前向计算 outputs = model(x) # 计算损失 loss = criterion(outputs, y) # 反向传播 loss.backward() optimizer.step()
losses.append(loss.cpu().data.item())
writer.add_scalar("loss", loss.cpu().data.item(), global_step=epoch) test(model, train_dl, DEVICE, global_step=epoch) if (epoch + 1) % 10 == 0: print('Epoch : %d/%d, Loss: %.4f' % (epoch + 1, epochs, np.mean(losses)))
writer.close()
def test(model, train_dl, DEVICE, global_step=0): ''' 测试
:param model: :param train_dl: :param DEVICE: :param global_step: :return: '''
writer = SummaryWriter("runs/test_data")
# 测试模型 model.eval() correct = 0 total = 0 for i, (x, y) in enumerate(train_dl): x = x.float().to(DEVICE) y = y.long().to(DEVICE) outputs = model(x).cpu() pred = torch.argmax(outputs, dim=1) total += y.size(0) correct += (pred == y).sum() print('准确率: %.4f %%' % (100 * correct / total)) writer.add_scalar("accurary", (100 * correct / total), global_step=global_step) writer.close()
if __name__ == "__main__": # 设置训练趟数 epochs = 20 learning_rate = 0.01
# 准备设备 DEVICE = torch.device("cpu") if torch.cuda.is_available(): DEVICE = torch.device("cuda") print(DEVICE) # 获得数据集 train_dl = getData(batch_size=1024) # 实例化模型 model = TabularModel().to(DEVICE)
writer = SummaryWriter("runs/model") writer.add_graph(model, torch.randn(1, 14)) writer.close()
train(model, train_dl, DEVICE, epochs=epochs, learning_rate=learning_rate)测试结果
模型结构图
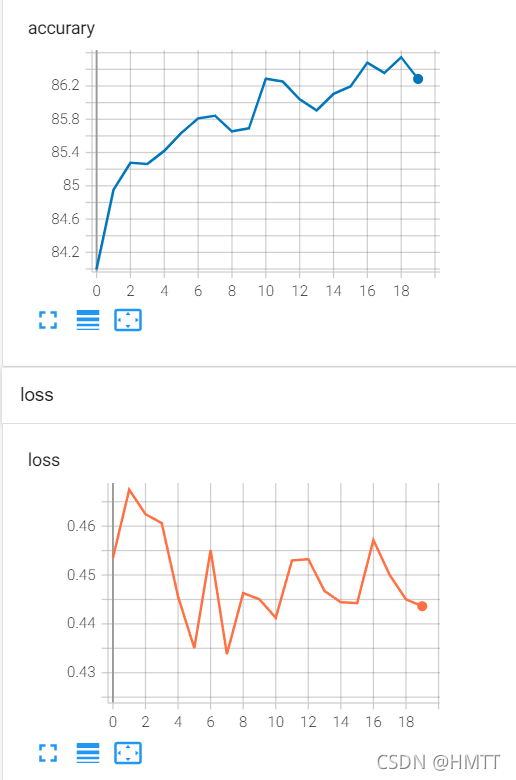
正确率和损失的变化图
注意
里面的模型结构和变化图都是用tensorboard完成的。关于tensorboard相关应用,可以参考pytorch学习19:pytorch下tensorboard的使用
原文链接:CSDN
pytorch学习20:处理结构数据实例
https://blog.homura.work/posts/csdn/120680192/