 HMT

1122 字
6 分钟
网络退化现象和残差网络效果
介绍
最近在网上看见了一个用神经网络实现“一个字符串的所有字母用它的后继字母代替(比如,a用b代替,b用c代替)”功能的代码。看见里面加了一个残差网络,就去看了一下残差网络的相关概念。如下这篇文章:
里面有提到网络退化(即深层网络的效率比不上浅层网络)的现象,于是我就想做个实验试试。
本次实验用到了三个网络:
- 的全连接神经网络
- 的全连接神经网络
- 在第二个网络的 处加了残差的神经网络
以上三个模型训练时使用的训练集完全一致。
环境
- pytorch==1.10
- tensorboard==2.7.0
代码
import string
import torchfrom torch import nnfrom torch.utils.data import Dataset, DataLoaderfrom tqdm import trangefrom torch.utils.tensorboard import SummaryWriter
# 驱动选择device = "cuda" if torch.cuda.is_available() else "cpu"
# tensorboardwriter_rn = SummaryWriter(log_dir = "runs/loss_rn")writer_nn = SummaryWriter(log_dir = "runs/loss_nn")writer_n = SummaryWriter(log_dir = "runs/loss_n")
print(f"Using {device} devive")
# 残差网络class RN(nn.Module): def __init__(self): super(RN, self).__init__() self.linear_stack = nn.Sequential( nn.Linear(26, 64), nn.Hardsigmoid(), nn.Linear(64, 26), nn.Hardsigmoid(), )
self.linear_stack_2 = nn.Sequential( nn.Linear(26, 64), nn.Hardsigmoid(), nn.Linear(64, 64), nn.Hardsigmoid(), )
self.output_layer = nn.Linear(64, 26)
def forward(self, x): y = self.linear_stack(x) # 残差 y = y+x y = self.linear_stack_2(y) y = self.output_layer(y)
return y
# 没加残差、其他结构完全一致的神经网络class NN(nn.Module): def __init__(self): super(NN, self).__init__() self.linear_stack = nn.Sequential( nn.Linear(26, 64), nn.Hardsigmoid(), nn.Linear(64, 26), nn.Hardsigmoid(), )
self.linear_stack_2 = nn.Sequential( nn.Linear(26, 64), nn.Hardsigmoid(), nn.Linear(64, 64), nn.Hardsigmoid(), )
self.output_layer = nn.Linear(64, 26)
def forward(self, x): y = self.linear_stack(x) # 此处没有参擦 # x = y+x y = self.linear_stack_2(y) y = self.output_layer(y)
return y
# 只有一层的神经网络class N(nn.Module): def __init__(self): super(N, self).__init__() self.linear_stack = nn.Sequential( nn.Linear(26, 64), nn.Hardsigmoid(), )
self.output_layer = nn.Linear(64, 26)
def forward(self, x): y = self.linear_stack(x) y = self.output_layer(y)
return y
# Dataset类class Data(Dataset): def __init__(self, x): """ x:[1...26, 0] """ self.data = list(
zip(x, list(range(1, 26)) + [0]) )
def __len__(self): return 26
def __getitem__(self, idx): return self.data[idx]
# 输出替换结果def trans_word(model, word): return "".join( alphabet_digit_map_reverse[model(alphabet_digit_map[w]).argmax().item()] for w in word )
# 生成两个模型实例rNetwork = RN().to(device=device)nNetwork = NN().to(device=device)n = N().to(device=device)
"""生成数据集a:[1, 0, ..., 0]b:[0, 1, ..., 0]...z:[0, 0, ..., 1]"""x = torch.zeros((26, 26), dtype=torch.float32).to(device=device)for i in range(26): x[i][i] = 1
# 生成数据集对象data = Data(x)dataloader = DataLoader(data, batch_size=1, shuffle=True)
# 定义损失函数和优化器loss_rn = nn.CrossEntropyLoss()loss_nn = nn.CrossEntropyLoss()loss_n = nn.CrossEntropyLoss()optimizer_rn = torch.optim.Adam(rNetwork.parameters(), lr=1e-3)optimizer_nn = torch.optim.Adam(nNetwork.parameters(), lr=1e-3)optimizer_n = torch.optim.Adam(n.parameters(), lr=1e-3)
# 训练, 三个个模型使用完全相同的数据for epoch in trange(500): for batch, (X, y) in enumerate(dataloader): X, y = X.to(device), y.to(device)
# 训练 rn pred = rNetwork(X) loss = loss_rn(pred, y) writer_rn.add_scalar("loss", loss.item(), global_step=epoch) optimizer_rn.zero_grad() loss.backward() optimizer_rn.step()
# 训练 nn pred = nNetwork(X) loss = loss_nn(pred, y) writer_nn.add_scalar("loss", loss.item(), global_step=epoch) optimizer_nn.zero_grad() loss.backward() optimizer_nn.step()
# 训练 n pred = n(X) loss = loss_n(pred, y) writer_n.add_scalar("loss", loss.item(), global_step=epoch) optimizer_n.zero_grad() loss.backward() optimizer_n.step()
# 关闭tensorboard流,保证信息所有输出完毕writer_rn.close()writer_nn.close()writer_n.close()
# 定义字母表到数字的映射alphabet_digit_map = dict(zip(string.ascii_lowercase, x))# 数字到字母的映射alphabet_digit_map_reverse = dict(zip(range(26), string.ascii_lowercase))
# a-zmy_word = string.ascii_lowercase# 输出结果print(trans_word(rNetwork, my_word))print(trans_word(nNetwork, my_word))print(trans_word(n, my_word))输出结果
bcdefghijklmnopqrstuvwxyzabidtfgtiiiidttptittitwiyiabcdefghijklmnopqrstuvwxyzatensorboard结果输出
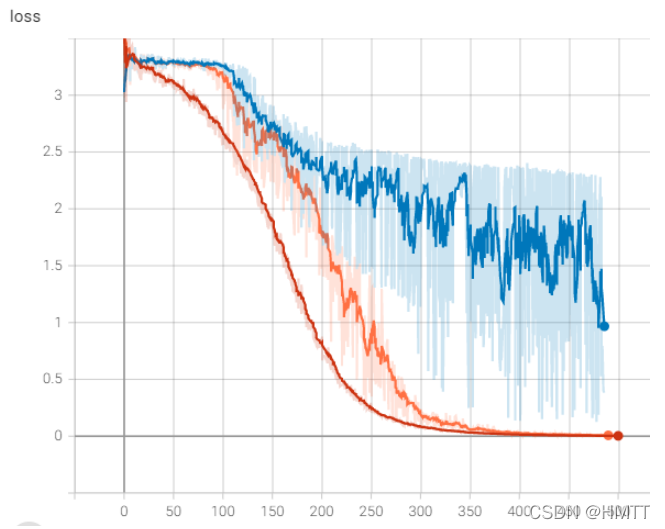
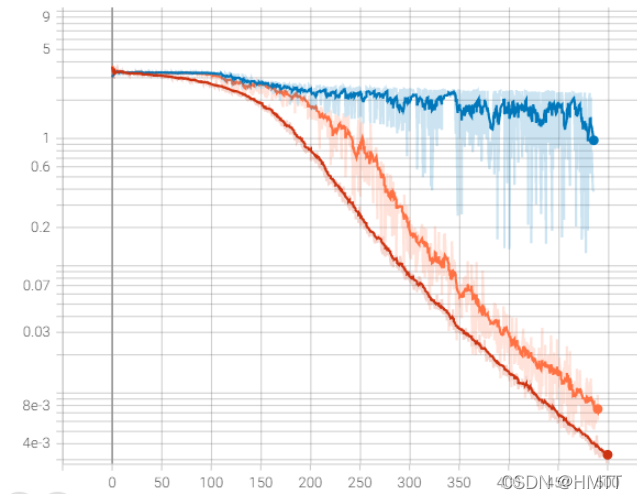
其中橙色是加了残差深层神经网络,蓝色是没加残差深层神经网络,红色是浅层神经网络。
总结
从整体来看,红色不管在收敛速度和最终结果来看,都是三个模型中最优的,且也是结构最简单的模型。蓝色(深层神经网络)是最拉跨的模型。
对比蓝色和红色,可以看到确实出现了网络退化的现象,红色的收敛速度远高于蓝色,且蓝色损失波动极大(背景浅蓝色是真实损失,深蓝色线是经过压缩的)。
对比蓝色和橙色,可以看出加了残差只有,网络的效率大幅度提升,可见残差在解决网络退化问题上效果很好。
对比红色和橙色,可以看到虽然残差解决了网络退化的一些问题,但收敛速度和最终效果仍没有浅层网络好,但这只是在这个简单模型、简单问题上的结果,残差在复杂模型(如Transformer)上有很多应用,并且取得了相当好的结果。
可见,一味地增加神经网络的深度并不一定可以获得更好的效果,正如奥卡姆剃刀原理如无必要,勿增实体,要更多地去关注问题本质。
原文链接:CSDN
网络退化现象和残差网络效果
https://blog.homura.work/posts/csdn/122584736/