 HMT

659 字
3 分钟
PyTorch Lightning基础入门
Lightning in 15 minutes
Lightning in 15 minutes — PyTorch Lightning 2.0.4 documentation
安装 PyTorch Lightning
pip install lightning
conda install lightning -c conda-forge
定义一个LightningModule
LightningModule可以让pytorch的nn.Module可以整合一些训练过程(也可以有验证和测试)。
如下是一个手写数字识别自动编码器(autoencoder)的样例:
import osimport torchfrom torch import optim, nn, utilsfrom torchvision.datasets import MNISTfrom torchvision.transforms import ToTensorimport lightning.pytorch as pl
'''定义两个模型,编码器和解码器,这个是pytorch的模型对象'''encoder = nn.Sequential(nn.Linear(28 * 28, 64), nn.ReLU(), nn.Linear(64, 3))decoder = nn.Sequential(nn.Linear(3, 64), nn.ReLU(), nn.Linear(64, 28 * 28))
# 定义LightningModuleclass LitAutoEncoder(pl.LightningModule): def __init__(self, encoder, decoder): super().__init__() self.encoder = encoder self.decoder = decoder
def training_step(self, batch, batch_idx): # 训练步骤 # 这个跟 forward 不相关 x, y = batch x = x.view(x.size(0), -1) z = self.encoder(x) x_hat = self.decoder(z) loss = nn.functional.mse_loss(x_hat, x) # 存储日志(需要安装Tensorboard) self.log("train_loss", loss) return loss
def configure_optimizers(self): # 优化器 optimizer = optim.Adam(self.parameters(), lr=1e-3) return optimizer
# 初始化自动编码器autoencoder = LitAutoEncoder(encoder, decoder)定义数据集
Lightning支持所有可迭代的数据集形式(DataLoader,numpy,以及其他)。
# setupdatadataset=MNIST(os.getcwd(),download=True,transform=ToTensor())train_loader=utils.data.DataLoader(dataset)训练模型
Lightning的Trainer对象可以整合LightningModule与不同数据集,并扩展了一些工程所需方法。
# 训练模型trainer = pl.Trainer(limit_train_batches=100, max_epochs=10)trainer.fit(model=autoencoder, train_dataloaders=train_loader)Trainer对象也实现了很多常用的过程:
Epoch和batch迭代。optimizer.step(),loss.backward(),optimizer.zero_grad()- 验证过程中的**
model.eval()。** - 模型存储和载入
- Tensorboard
- 多GPU
- TPU
- 半精度混合
【注意】:在jupyter下,多卡训练可能会报错,可以试试直接用python代码。
使用模型
训练完模型后,可以导出到 onnx、torchscript 并将其投入生产,或者只是加载权重并运行预测。
# 载入模型checkpoint = "./lightning_logs/version_0/checkpoints/epoch=0-step=100.ckpt"autoencoder = LitAutoEncoder.load_from_checkpoint(checkpoint, encoder=encoder, decoder=decoder)
# 选择训练好的编码器encoder = autoencoder.encoderencoder.eval()
# 编码图片fake_image_batch = torch.randn(8, 28 * 28).to(next(encoder.parameters()).device)embeddings = encoder(fake_image_batch)print("⚡" * 20, "\nPredictions (4 image embeddings):\n", embeddings, "\n", "⚡" * 20)训练可视化
如果安装了Tensorboard,可以用它来观察实验过程。
tensorboard --logdir .额外训练设置
# 4gpu训练trainer = Trainer( devices=4, accelerator="gpu", )
# train 1TB+ parameter models with Deepspeed/fsdp# 使用 Deepspeed 训练大模型trainer = Trainer( devices=4, accelerator="gpu", strategy="deepspeed_stage_2", precision=16 )
# 20+ helpful flags for rapid idea iteration# 有助于快速迭代的一些设置trainer = Trainer( max_epochs=10, min_epochs=5, overfit_batches=1 )
# access the latest state of the art techniques# 获取最新的技术trainer = Trainer(callbacks=[StochasticWeightAveraging(...)])一些灵活设置
定制训练循环
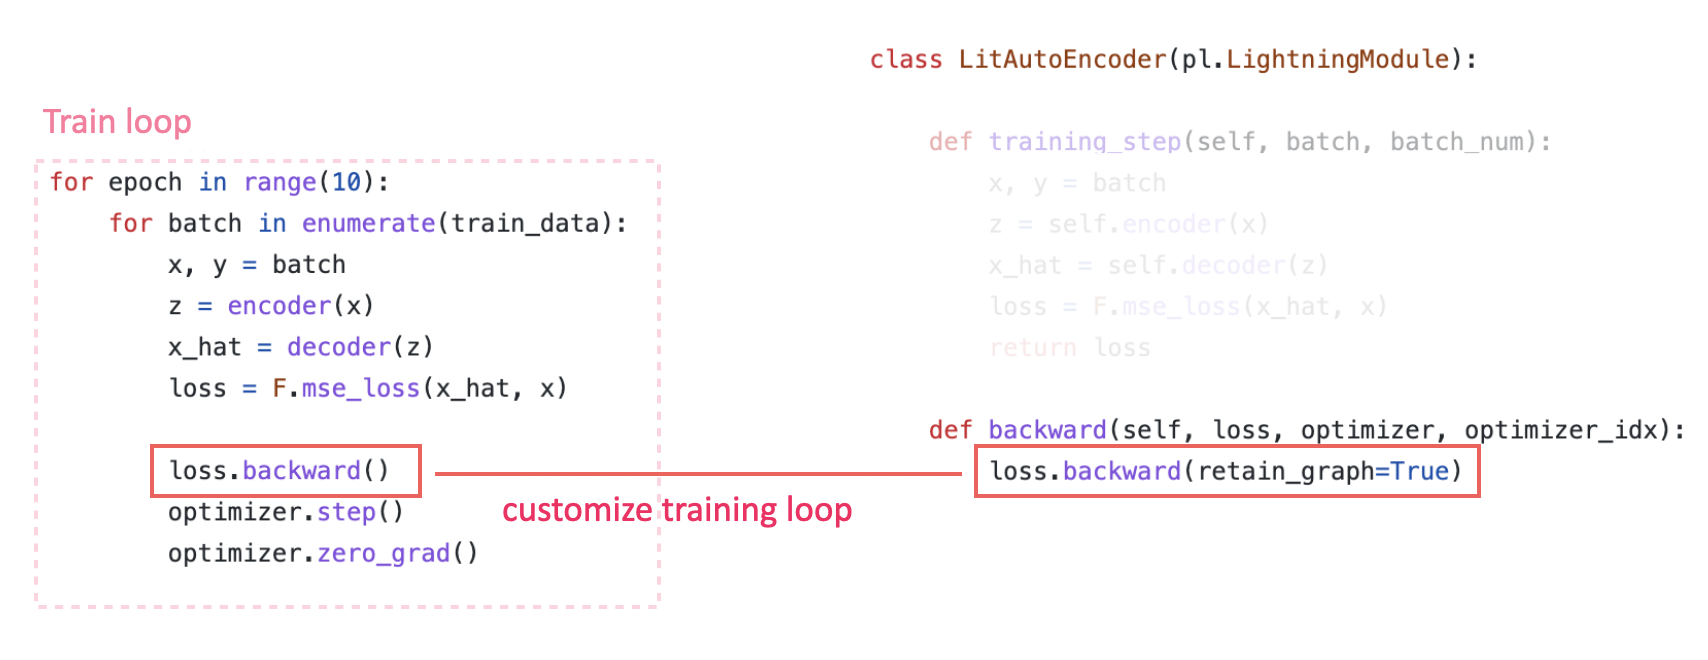
LightningModule中设置了20多种断点(HOOK),可以用来定制训练过程:
class LitAutoEncoder(pl.LightningModule): def backward(self, loss): loss.backward()扩展Trainer
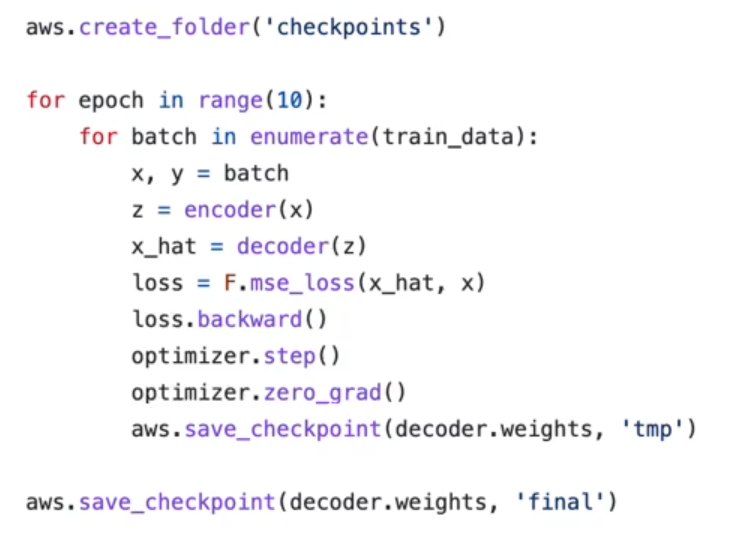
在上面这个代码种,对模型的存储进行了一些设置。这些设置可以在pl.Callback对象中实现,并导入Trainer对象。
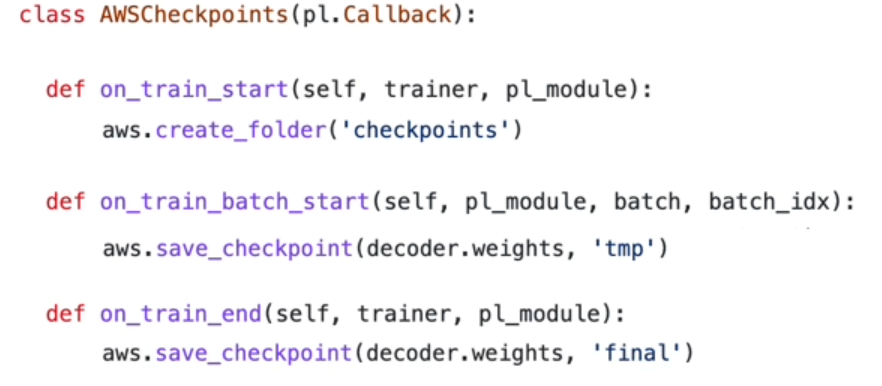
用如下方式可以导入Trainer:
trainer = Trainer(callbacks=[AWSCheckpoints()])原文链接:CSDN
PyTorch Lightning基础入门
https://blog.homura.work/posts/csdn/131443795/