 HMT

604 字
3 分钟
图的深度优先搜索
图的深度优先搜索
算法描述
- 找一个未被访问过的结点,并访问它
- 找到该节点一个未被访问过的相邻结点,并访问,再找未被访问过的相邻结点。
- 重复2,直到某个结点没有未被访问过的相邻结点,这时退回上一个访问的结点再重复2,直到访问完的所有相邻结点
- 若此时仍有未被访问过的结点,重复1
设计思维
- 可以给每个结点一个序号,然后创建一个相应长度的数组,初始化为全1数组,该数组索引代表结点序号,内容表示结点是否被访问过。若访问过则赋值为0。
- 为了方便找到上一个访问过的结点,可以使用栈来记录访问次序。
- 图可以用邻接表表示。邻接表可以比邻接矩阵更快速地找到相邻的结点。
算法实现——用栈
// 邻接表深度优先搜索/*vers:结点数组len:结点个数*/void graph_list_DFS_stack(VertexNode** vers, int len, char* pattern){ int vs_find[len]; // 标记某个节点是否已经被访问 VertexNode** vs_stack = (VertexNode** )malloc(sizeof(VertexNode*) * len); // 用来当栈使用
// 初始化矩阵 for(int i = 0; i < len; i++) { vs_find[i] = 1; }
int index = -1; VertexNode* current = NULL; ArcNode* arc = NULL;
while(1) { if(current == NULL) // 如果当前节点为空,说明已经访问完一个连通分量 { for(int i = 0; i < len; i ++) { if(vs_find[i]) { current = vers[i]; vs_stack[++index] = current; printf(pattern, i); // 访问当前节点 vs_find[i] = 0; // 标记为已访问 break; } }
if(current == NULL) return; // 所有结点都被访问 }
arc = current->firstarc; while(arc) { if(vs_find[arc->adjvex]) // 有未被访问的邻接节点 { current = vers[arc->adjvex]; vs_stack[++index] = current; printf(pattern, arc->adjvex); // 访问第一个未被访问的相邻节点 vs_find[arc->adjvex] = 0; break; } arc = arc->nextarc; }
/* 如果所有当前节点所有相邻点都被访问过, 且栈中还有节点 返回最近一次访问的节点 */ if(arc == NULL) { if(index >= 0) { current = vs_stack[index--]; } else current=NULL; } }运算结果
- 测试代码
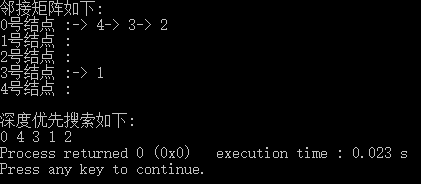
int main(){int arr[15] = {0,2,1,0,3,1,0,4,1,3,1,1};VertexNode** vers = graph_list_VerArr(5);graph_list_createAdjacencyMatrixByArrWithWeight(vers, arr, 12, 1);printf("邻接矩阵如下:\n");graph_list_print(vers, 5, "%d号结点 :", "-> %d");printf("\n深度优先搜索如下:\n");graph_list_DFS_stack(vers, 5, "%d ");return 0;}
- 运行结果
原文链接:CSDN