 HMT

CIDEr(Consensus-based Image Description Evaluation)
论文原文 CIDEr: Consensus-based Image Description Evaluation
CIDEr(Consensus-based Image Description Evaluation)是一种用于自动评估图像描述(image captioning)任务性能的指标。它主要通过计算生成的描述与一组参考描述之间的相似性来评估图像描述的质量。CIDEr的独特之处在于它考虑了人类对图像描述的共识,尝试捕捉描述的自然性和信息量。
计算过程
定义
计算关于图片 生成的描述 与一组给定图片描述 的一致性。
计算一个词组(wk)的权重
一个n-gram词组 出现在参考句子(生成描述)中的次数记为 ( )。
首先,为每个n-gram词组 计算TF-IDF权重( ):
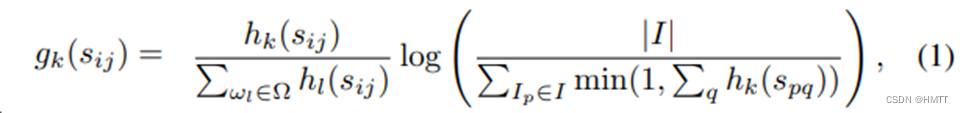
其中 表示包含所有n-gram词组的词典, 是数据集中所有图片的集合。
前面的算式计算的是每个 的TF,第二个算式计算的是 的稀有程度(IDF)。
简单来说,
,
前面是词组在当前句子中的重要程度,后面是词组在整个数据集中的出现概率的倒数。整体作用跟tf-idf类似。
TF-IDF(term frequency–inverse document frequency)
TF-IDF是一种统计方法,用以评估一字词对于一个文件集或一个语料库中的其中一份文件的重要程度。
百度百科:TF-IDF(term frequency–inverse document frequency)是一种用于信息检索与数据挖掘的常用加权技术。TF是词频(Term Frequency),IDF是逆文本频率指数(Inverse Document Frequency)。
顾名思义,Tf-idf由tf和idf两部分组成,tf是指一个词在当前document里面出现的频率,idf是指这个词在全体语料库中出现频率的倒数。根据这个定义,说明一个词对于一个document的重要程度与这个词出现在当前document的频率成正比,与出现在全体语料库中的频率成反比。通俗理解,一个词在一篇文章中出现次数越多,这个词对这篇文章越重要;在全体语料中出现频率越多,说明,这个词只是一个常用词而已,两者乘积就是Tf-idf。注意:这里document不一定是文章,可能是句子之类的,或者是其他的。
公式为:
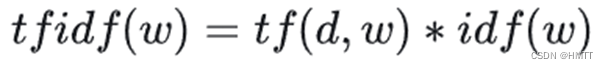
其中 是文档d中w的词频, ,+1是为了避免单词未出现导致分母为0。
- N表示预料中的文本总数
- N(w)表示w出现在多少个文档中。
当某个词在当前文档中出现频率比较高,而且在整体语料库中的出现的概率较小,这样的词会获得较大权重,因此TF-IDF倾向于过滤掉常见的词语,而保留对某一篇文档来说出现频率高的词。
这里需要补充一点,tf是一个词在当前文档中的词频,也就是这个词出现的次数,这里就引出了另外的一个问题,就是如果某篇文档的总词数远大于其他文档,那么不管重要与否它的词通常拥有更高的词频,因此通常对tf进行归一化,也就是用当前文档某个词的词频除以当前文档总词数。
计算n-gram的CIDEr
对于n-gram的某个特定情况,如n=1,2,…,会有一个特定的值 ,计算公式如下:
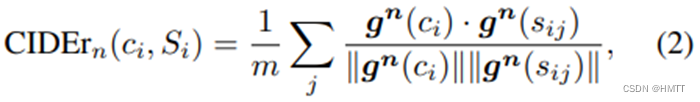
其中 是一个向量,由所有当前设置n下的词组计算的 构成, 是向量的长度,用来归一化。 计算方式一样; 为当前图片所拥有的给定描述长度。
简单来说,
这里的”所有n-gram词组”应该是 ,即候选句子和给定句子集合中的所有n-gram词组。
整体CIDEr
就是循环计算n=1,2,3,…的 ,然后求均值:
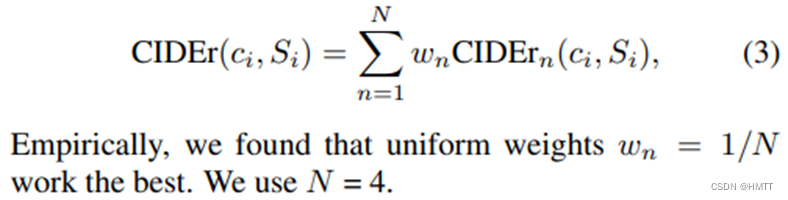
原文链接:CSDN